信道码可以分为两大类:分组码和卷积码。
在块码中,M =
 个消息中的一个,每个消息表示一个长度为k的二进制序列,称为信息序列,映射到一个长度为n的二进制序列,称为码字,其中n > k。码字通常通过发送n个二进制符号的序列在通信信道上传输,例如,通过使用BPSK。QPSK和BFSK是经常用于码字传输的其他类型的信令方案。
分组码是无记忆性的。一个码字被编码传输后,系统接收到一组新的k个信息位,并使用编码方案定义的映射对其进行编码。产生的码字仅依赖于当前的k个信息位,与之前传输的所有码字无关。
卷积码是用有限状态机描述的。在这些码中,在每个时间实例i, k个信息位进入编码器,在编码器输出处产生n个二进制符号,使编码器的状态从
 变为

可能状态的集合是有限的,用
 表示。编码器输出产生的n个二进制符号和下一个状态
取决于输入j寄存器的kK位以及
。如图所示
码率定义为
长度为n的码字使用N维空间的M-ary调制,
 定义为每个码字传递的符号数,假设每个符号的传递时间为
 ,由此传递速率为
假设采用最小的所需带宽进行采样(采样定理)带宽为
由此可以得到频谱效率为
与使用相同调制方案的非编码系统相比,比特率变化了Rc倍,带宽变化了1/Rc倍,即速率降低了,带宽增加了。
从能量的角度来看
所有星座点的平均能量为
 ,每个码字的能量为
 ,由此
码字中每一个比特能量为
输入每比特的能量用Eb表示,可由
码字和输入的每比特能量关系
传输功率定义为
传输功率 = 传输每比特能量 × 每比特的速率
对于BPSK、BFSK和QPSK (N = 2,复数域?)有
对于四则运算封闭。
如果满足下列性质,则集合G和用+表示的二元运算构成Abelian组满足:
表示为

有限域或Galois field是一个有限集合F,它具有两个二元运算:加法和乘法,分别用+和·表示,满足下列性质:
-
{F, +, 0}是一个Abelian组
-
{F−{0},·,1}是一个Abelian 组;即,域的非零元素与单位元素“1”相乘构成一个阿贝尔群。a∈F的乘法逆记为

-
满足乘法分配率
实数集R是一个域(但不是有限域),具有普通的加法和乘法。具有模-2加法和乘法的集合F ={0,1}是GF域的一个例子。这个域称为二进制域。
有q个元素的GF域,用GF(q)表示,存在当且仅当
 ,p是质数,m是正整数。
当q = p时,伽罗瓦场可表示为GF(p) ={0,1,2,…, p−1}与模p的加法和乘法。例如GF(5) ={0,1,2,3,4}是一个具有模5加法和乘法的有限域。
当
时,得到的GF域称为GF(p)的扩展域。在这种情况下,GF(p)称为GF(
 )的Groud field,p称为GF(pm)的特性
有限域的多项式
为了研究扩展域的结构,我们需要定义GF(p)上的多项式
多项式的加法和乘法遵循普通多项式的标准加法和乘法规则,只是系数的加法和乘法是模p的。
如果一个m次多项式在GF(p)上不能写成同一个GF域上两个较低次多项式的乘积,则该多项式称为不可约多项式。
 在GF(2)上是一个不可约的多项式,
 是可约的。
代数的一个基本结果表明,次数为m 的GF(p)的多项式有m个根(有些可以重复),但根不一定在GF(p)中。一般情况下,根在GF(p)的扩展域中。
扩展域的结构
从上述定义可以清楚地看出,存在
个多项式次数小于m;特别地,这些多项式包括两个特殊的多项式g(X) = 0和g(X) = 1。现在让我们假设g(X)是一个m次的素数(一元不可约)多项式,并考虑所有次数小于m 在 GF(p)的多项式的集合,这些多项式具有原来的加法和多项式乘法模g(X)。可以证明,这些多项式的加法和乘法运算的集合是一个有
个元素的GF域。
我们知道
 是素数多项式在GF(2)。因此,这个多项式可以用来构造GF(
 ) = GF(4)。让我们考虑所有次数小于2 的。这些多项式是0、1、X和X + 1,其加法和乘法表所示。注意,乘法法则基本上需要将两个多项式相乘,将乘积除以g(X) =
 ,然后求余数。这就是模g(X)相乘的意思。有趣的是,GF(4)的所有非零元素都可以写成X的幂;即
 (这是通过除以g(X)取余得到的 )
乘法计算过程
为了生成GF(
 ),我们可以使用两个素数多项式g1(X) =
 或g2(X) =
 中的任何一个。若取g(X) =
 ,
定义:对于任何一个在GF(q)域中的非零值β,都满足
 的i的值成为β的order(序数)。显然在GF(q)域中有
 ,因此β的序数最大不会有q-1.
初元素(primitive element)定义为他们的次数能构成GF域中所有的非零值,序数为q-1.。
对于最大次数为m的多项式中,有许多素数多项式。
对于一个GF(
),如果是由g(x)生成的话,同时X是这个域的初元素,这这个生成多项式g(x)是初多项式。
因为
 ,所以第二个多项式不是素数多项式。
初多项式的第二个判断准则:
对于一个在GF(p) 的自由度为m(最高次为
)多项式,则一定可以被多项式
 整除。但同时可能存在可以
 被整除。如果不存在比
 小的i使得上述式子成立,这个素数多项式是初多项式。
线性分组码的一般性质
线性分组码C是n维空间的一个k维子空间,通常称为(n,k)码对于二进制码,线性分组码是长度为n的2k个二进制序列的集合,使得对于任意两个码字 C1,C2,我们有C1+c2也属于这个线性分组码的集合。显然,0是任何线性分组码的码字。
生成矩阵和奇偶校验矩阵
G表示生成矩阵,u为输序列,c为输出码字。
生成矩阵表示为向量
输出码字为
系统的生成矩阵
码字存在纯在互补空间满足:
对于二进制码
通过选择阿达玛矩阵的行作为码字来获得阿达玛码。
阿达玛矩阵Mn是一个由1和0组成的n × n矩阵(n是一个偶数),它的性质是任意一行与其他行相差正好n个位置。†矩阵的一行包含所有0。其他行各包含n个0和n个1。
例如n = 2,
 表示补码(0被1替换,反之亦然)

我们知道,在最小化码字错误平均概率的意义上,AWGN信道的最佳接收器可以实现为与M个可能的发射波形相匹配的
 滤波器的并行组。
比较每个信令间隔结束时M个匹配滤波器的输出,其中包含码字中n个二进制符号的传输,并选择最大匹配滤波器输出对应的码字。
 表示匹配滤波器对任何特定码字的n个采样输出,由于信号是二进制相干PSK,输出rj可以表示为:
当码字的第j位是1时
当码字的第j位是0时
最佳解码器形成M个相关度量
 表示第m位码字的第j位。.
因此,若
 ,则权重因子
 ;如果
 ,则权重因子
 。这样,加权
 将{rj}中的信号分量对齐,使得与实际传输码字对应的相关度量将具有平均值
 ,而其他M−1度量将具有较小的平均值。
对于码字数目较大,这可能不切实际例如

块误码率和比特误码率
BPSK有
我们还看到,使用编码BPSK信号导致带宽适度扩展,同时,通过提供编码增益,提高了系统的功率效率。
让我们考虑两个系统,一个采用正交信号,另一个采用编码BPSK信号来实现相同的性能。
对于正交误码性能
对于编码误码性能
两者一样性能下,输入的比特长度满足
 ,每个比特正交下需要维度
 。计算为

BPSK码波形的维数
 (输出的波形的比特数)
假设我们使用最小距离为dmin = 13的(63,30)二进制码。相对于此代码,正交信令的带宽比大致为205。换句话说,执行类似于(63,30)码的正交信令方案需要编码系统带宽的205倍。这个例子清楚地显示了编码系统的带宽效率。
线性分组码的硬解码
软解码是采样点没有进行量化的结果。虽然这种处理产生了最好的性能,但基本的限制是形成M个相关指标并比较这些指标以获得最大的计算负担。
为了减少计算量,可以对模拟样本进行量化,然后对解码操作进行数字化处理。
在本节中,我们考虑一种极端情况,即对应于码字的单个比特的每个样本被量化为两个级别:0和1。
AWGN信道下,(调制器/解调器)构成一个交叉概率为p的BSC。对于PSK
最小距离译码(ML)
接收到的码字相对应的来自检测器的n位被传递到解码器,h将接收到的码字与M个可能传输的码字进行比较,选择汉明距离中最接近的码字。
这种最小距离解码规则是最优的,因为它导致二进制对称信道的码字错误概率最小。
所有M个可能传输的码字
 ,以获得误差向量
 ,
表示为了转换码字为特定接收码字上发生的错误。转换为接收到的码字时的错误数正好等于
中1的个数,简单地计算M个误差向量
{
}的权重,并决定选择产生最小权重误差向量的码字,就是最小距离译码规则的实现。
标准差错阵列
一种更有效的硬判决解码方法是利用奇偶校验矩阵。
 为发射码字,
 为探测器输出端的接收序列,
 表示任意二进制误差向量。有
(n−k)维向量
 表示差错模式。向量s的分量对于所有满足的奇偶校验方程为零,对于所有不满足的奇偶校验方程为非零。
如果s等于零,在这种情况下,我们有一个未检测到的错误(y是原来的码字空间的码字)。
如果s不等于零,这种情况下,有一个错误模式(向量e)没有被检测到。
因此所有的
 接受差错模式(全零序列不算作错误),
 个是无法被检测(收到啥就是啥)。
 可以检测到非零错误模式,但并非所有错误模式都可以纠正。
因为接受向量维度为n-k,所以只有
 个可以纠错的错误模式。
标准差错阵列
例子,如何使用差错模式和标准差错阵列
(5,2)线性码生成矩阵
差错检测能力和差错纠错能力
从上面的讨论可以清楚地看出,当s由全零组成时,所接收的码字是个可能的
 传输码字之一。因为码字之间的最小间隔是
 ,可能将代码中的这
个码字中的一个转换为另一个码字(至少发生
 位比特错误)。当发生这种情况时,我们有一个未检测到的错误。另一方面,如果实际误差数小于最小值
(说明检测的一定不是输出的码字集合中的一个),s会有非零值。当出现这种情况时,我们已经检测到通道上存在一个或多个错误。
(n, k)块码能够检测到
 的错误。
码的纠错能力也取决于最小距离,可纠正错误模式的数量受限于标准数组中每一列的数量。
为了确定(n, k)码的纠错能力,可以方便地将
 个码字视为n维空间中的点。如果将每个码字视为半径为(汉明距离)t的球体的中心,没有交集的情况下t可能具有的最大值

在每个球内存放距离有效码字小于等于t的所有可能接收码字。因此,任何落在球体内的接收代码向量都被解码为球体中心的有效码字。
距离最小的(n, k)码具有纠错能力

显然,纠正t个错误意味着我们已经检测到t个错误。然而,如果我们牺牲了代码的纠错能力,也有可能检测到超过t个错误。
对于
 的(n,k)码能最多修正3个错误。 如果我们希望检测四个错误,我们可以通过将每个码字周围的球体半径从3减小到2来实现,因此,具有四个错误的模式是可检测的,但只有两个错误的模式是可纠正的。(当把半径减小到2时候,发送一个码字,当接受码字距离这个码字的
 的时候这个时候一定是知道有错的,如果发生
 以上的错误的时候,由于进入了其他的码字的纠错区域,会被自动纠错成其他码字而不认为出错,所以就无法无法检测出出错)。
所以有检错能力
 和纠错能力
 满足
对于比特误码率,我们注意到,如果发送0,接收权值为t + 1的序列。解码器会将接受序列译成距离接收序列最多为t的码字,这意味着对于最优可能的块出错有2t + 1位错误。所以
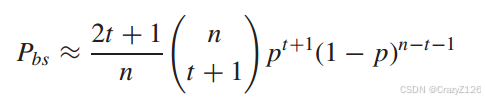 (高信噪比)
假设我们在每个可能传输的码字周围放置一个半径为t的球体,码字周围的每个球包含到码字汉明距离小于等于t的所有码字的集合。一个球体中码字的数目
 可能传输的码字,
 不重叠的球,每个球的半径为t。
个球中包含的码字总数不能超过
 个可能接收到的码字。所以纠错能力为t的码必须满足不等式
对于这样的码,权重小于或等于t的所有错误模式都由最佳(最小距离)解码器纠正。另一方面,任何权重为t + 1或更大的错误模式都不能被纠正。
M个可能传输码字周围的汉明半径为t的所有球都是不相交的,并且每个接收码字与其中一个可能传输码字的距离最多为t +1。所有权值小于或等于t的误差模式和一些权值为t + 1的误差模式都是可修正的。有块误码率
球外的码字总数为
平均每一个球可以扩大的区域有
因此,在与每个码字的距离为t+1的
 错误模式中,我们可以纠正
 个错误模式。
于是准最优码的块误码率
从最小距离的角度,块误码率大于将传输的码字错误地解码为其最近邻居的概率
上界译成其他所有的码字的概率
从权重枚举函数来看如果
 则有
线性分组码
线性分组码
的概念
线性码中信息位和监督位是由一些线性代数方程联系着的,或者说线性码使按照一组线性方程构成的。汉明码是一种能够纠正一位错码并且编码效率较高的
线性分组码
。下面将介绍汉明码的构造原理。
汉明码的构造原理
一般来说,若码字长度为nnn,信息位位数为kkk,则监督位数r=n−kr=n-kr=n−k。若果希望用rrr个监督位构造出rrr个监督关系式来只是一位错码在码字中的n中可能位...